ElevenLabs no n8n: tutorial de voz IA em 2026
Por Maicon Ramos · · 13 min de leitura
Navegue por tópicos
- Resposta curta: o fluxo mínimo para gerar áudio no n8n
- Antes de montar: calcule o Custo por Fala Gerada
- Caminho 1: usando o node oficial da ElevenLabs no n8n
- Caminho 2: usando HTTP Request para chamar a API da ElevenLabs
- Como salvar o MP3 e enviar para WhatsApp, Drive ou webhook
- Qual modelo escolher para cada uso
- Workflow de produção: retry, cache, logs e limite de custo
- Casos de uso no Brasil
- Problemas comuns e como resolver
- FAQ
- Vale usar ElevenLabs no n8n?
Para usar ElevenLabs no n8n, receba o texto, envie um POST ao endpoint de Text-to-Speech, trate a resposta como áudio binário e salve ou entregue o MP3. Antes de escalar, proteja a API key, limite retries e calcule o custo por caracteres para evitar gasto duplicado.
Você pode ligar a ElevenLabs ao n8n por um node oficial, quando ele estiver disponível, ou pelo node HTTP Request. O fluxo útil não termina no primeiro áudio: ele recebe um texto, gera o MP3, salva ou envia o arquivo e registra consumo. Para produção, proteja a API key, limite retries e evite gerar o mesmo áudio duas vezes.
Em termos práticos, a arquitetura é esta: gatilho por webhook ou formulário, limpeza do texto, chamada de Text-to-Speech, resposta binária, armazenamento ou envio e log de custo.
A ElevenLabs documenta o endpoint de conversão e o retorno de áudio. O n8n fornece recursos para chamar APIs e manipular arquivos binários. Consulte o endpoint oficial de Text to Speech da ElevenLabs antes de adaptar parâmetros adicionais ao seu fluxo.
Resposta curta: o fluxo mínimo para gerar áudio no n8n
💡 Vai rodar n8n numa VPS? A gente comparou o preço real em cada provedor — com renovação e requisitos — em VPS para n8n.
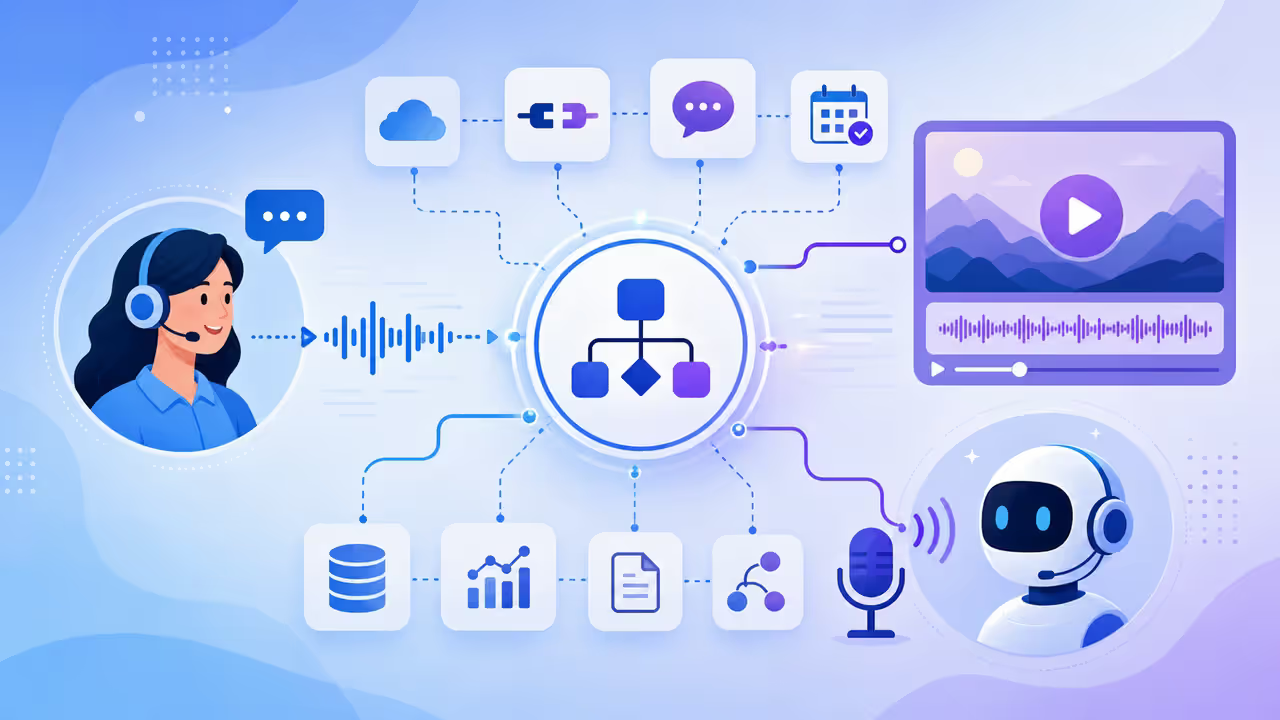
O caminho mínimo tem cinco partes:
- Receba um texto em um Webhook, formulário ou node de agendamento.
- Limpe o conteúdo e defina
voice_idemodel_id. - Faça um
POSTpara a API da ElevenLabs. - Trate a resposta como arquivo binário de áudio.
- Envie o MP3 para Drive, armazenamento compatível com S3, WhatsApp ou outro webhook.
Esse desenho separa o que é dado do que é transporte. O texto entra como JSON. O áudio sai como binário. Misturar os dois costuma causar o erro clássico: a chamada responde com sucesso, mas o próximo node recebe uma estrutura que não consegue anexar ou salvar.
A integração verificada no n8n Cloud reduz o trabalho de configuração para recursos suportados. Ainda assim, a página de integrações do n8n aponta o HTTP Request pré-autenticado como alternativa para casos não cobertos.
Isso importa em ambientes self-hosted, em funções novas da API e no diagnóstico de payloads. A integração verificada no n8n Cloud é a rota simples; HTTP Request é a rota universal.
Quando usar o node oficial
Use o node oficial se ele aparecer no seu ambiente e a operação desejada estiver disponível. Ele tende a acelerar a criação da credencial e diminui erros de digitação em headers ou URLs. O repositório oficial da ElevenLabs para n8n cobre Text to Speech, Speech to Text e Conversational AI, mas a disponibilidade pode variar conforme versão e ambiente.
Quando usar HTTP Request
Use HTTP Request quando precisar ver cada parte da chamada, controlar headers e corpo, escolher uma opção recente da API ou manter um workflow portátil. Para quem está decidindo a plataforma de automação, vale também comparar as diferenças de operação no comparativo n8n vs Make.
Critério | Node oficial | HTTP Request |
|---|---|---|
Configuração inicial | Mais rápida | Manual |
Controle do payload | Depende dos campos expostos | Total |
Features novas | Podem chegar depois | Podem ser chamadas quando documentadas |
Debug | Mais abstrato | URL, header e resposta ficam visíveis |
Melhor uso | Fluxo suportado e estável | Produção, exceções e integrações sob medida |
Antes de montar: calcule o Custo por Fala Gerada
O conceito deste tutorial é Custo por Fala Gerada: o custo real de cada áudio na automação, calculado por caracteres, modelo e repetições. Não olhe só para o preço mensal. Um fluxo pode parecer barato em um teste manual e ficar caro ao responder milhares de mensagens ou refazer a mesma chamada por erro.
Segundo os preços oficiais da API ElevenLabs, Text-to-Speech custa US$ 0,05 por mil caracteres em Flash/Turbo e US$ 0,10 por mil caracteres em Multilingual v2/v3. A tabela abaixo usa R$ 5,50 por dólar apenas como referência operacional. A cotação muda; o método de cálculo, não.
Caso | Caracteres | Flash/Turbo | Multilingual/v3 |
|---|---|---|---|
Mensagem curta de WhatsApp | 300 | US$ 0,015 / cerca de R$ 0,08 | US$ 0,030 / cerca de R$ 0,17 |
Resposta de atendimento | 800 | US$ 0,040 / cerca de R$ 0,22 | US$ 0,080 / cerca de R$ 0,44 |
Vídeo curto | 900 | US$ 0,045 / cerca de R$ 0,25 | US$ 0,090 / cerca de R$ 0,50 |
Vídeo explicativo | 9.000 | US$ 0,450 / cerca de R$ 2,48 | US$ 0,900 / cerca de R$ 4,95 |
1.000 atendimentos de 800 caracteres | 800.000 | US$ 40,00 / cerca de R$ 220,00 | US$ 80,00 / cerca de R$ 440,00 |
A conta explica por que cache e deduplicação são requisitos de produção. Se um cliente pedir para ouvir novamente a mesma mensagem, não há motivo para pagar por outra síntese. Salve o arquivo e use uma chave baseada no texto, na voz e no modelo.
Se você quer avaliar planos, recursos de dublagem e clonagem de voz antes de colocar o fluxo no ar, veja a oferta da ElevenLabs no Runzos. Ela é a rota comercial correta; a documentação oficial fica para especificações técnicas.
Caminho 1: usando o node oficial da ElevenLabs no n8n
Comece criando uma credencial no n8n. A chave da API deve ficar no recurso de credenciais ou em uma variável segura do ambiente. Não coloque o segredo em um node Set, em uma URL, em anotações do workflow ou em capturas de tela. Isso reduz o risco de vazar a chave quando o fluxo for compartilhado ou exportado.
Depois, adicione o node da ElevenLabs e selecione a operação de Text to Speech. Informe a credencial, a voz disponível na sua conta, o texto de entrada e o modelo. Faça o primeiro teste com uma frase curta. O objetivo inicial é confirmar autenticação, voz e formato do resultado; não é executar uma campanha inteira.
Quando o node não aparecer, não trate isso como bloqueio. Confira a versão do n8n, a política do ambiente e a disponibilidade de nodes verificados. Em seguida, use o caminho HTTP Request abaixo. A arquitetura posterior continua igual: entrada, chamada, binário, destino e observabilidade.
Caminho 2: usando HTTP Request para chamar a API da ElevenLabs
O node HTTP Request é a forma mais transparente de integrar uma API REST. A documentação do n8n explica suas opções de requisição e de resposta; ela é a referência para ajustes específicos do node. Leia a documentação do node HTTP Request do n8n se os nomes de campos variarem na sua versão.
Endpoint, método e voice_id
Adicione um HTTP Request após o node que prepara o texto. Configure o método como POST e use a URL abaixo. Troque o marcador pelo voice_id da voz escolhida na sua conta. Não invente um ID de exemplo: cada biblioteca de vozes usa identificadores próprios.
POST https://api.elevenlabs.io/v1/text-to-speech/{voice_id}Content-Type: application/jsonxi-api-key: credencial-segura
O endpoint converte o texto em fala e retorna áudio. Deixe o voice_id em um campo de configuração ou em uma variável do workflow caso sua automação use mais de uma voz.
Header xi-api-key sem expor segredo
Inclua Content-Type: application/json e xi-api-key nos headers. O valor da chave deve vir da credencial segura configurada no n8n. A autenticação por API key da ElevenLabs documenta o header exigido.
Um erro 401 ou 403 costuma pedir uma revisão simples: chave ativa, credencial selecionada, header com o nome correto e permissões do plano. Não publique logs com o valor completo da chave. Se for registrar falhas, armazene código HTTP, mensagem resumida e identificador interno da execução.
Body JSON mínimo
No corpo JSON, envie o texto e o modelo. Este é um request mínimo funcional para o fluxo:
{ "text": "Olá! Este é um teste de voz gerada pela ElevenLabs dentro do n8n.", "model_id": "eleven_flash_v2_5"}
Antes da chamada, elimine HTML bruto, instruções internas e dados pessoais que não sejam necessários. TTS não precisa receber o histórico inteiro de um atendimento para narrar uma resposta curta. Menos texto reduz exposição e custo.
Como escolher model_id
A documentação da ElevenLabs posiciona Flash v2.5 para casos que pedem velocidade e baixa latência do modelo. Isso não significa 75 ms de ponta a ponta no n8n: rede, fila, workflow e destino somam tempo. Para notificações, respostas rápidas e alto volume, Flash/Turbo é a escolha econômica. Para narrativa, vídeo e voz de marca, Multilingual ou v3 tende a fazer mais sentido quando a qualidade expressiva justifica o custo maior.
Como salvar o MP3 e enviar para WhatsApp, Drive ou webhook
A API responde com áudio. No n8n, isso precisa ser tratado como dado binário, não como uma string JSON comum. Configure a resposta do HTTP Request para receber arquivo ou binário conforme a sua versão do node. A documentação de dados binários no n8n ajuda a entender como o workflow representa arquivos.
Dê um nome previsível ao áudio, como tts-{{ $execution.id }}.mp3, ou use um identificador interno não sensível. Evite colocar telefone, nome completo ou conteúdo da mensagem no nome do arquivo. Depois, direcione o binário para o node adequado ao seu destino:
- Google Drive, S3 ou armazenamento compatível para guardar e reutilizar o arquivo;
- um conector de mensageria que aceite mídia para enviar uma resposta de áudio;
- outro HTTP Request para anexar o MP3 a um sistema interno;
- Write Binary File apenas em ambientes onde gravar no disco faz sentido e é persistente.
Não assuma que o disco de uma instância temporária guarda arquivos para sempre. Em automação hospedada, armazenamento externo costuma ser mais confiável. Confirme também o formato aceito pelo canal final. Se a plataforma pedir OGG, WAV ou outro codec, ajuste a geração ou faça a conversão em uma etapa controlada.
Qual modelo escolher para cada uso
Caso de uso | Escolha inicial | Motivo | Cuidado |
|---|---|---|---|
Atendimento rápido | Flash/Turbo | Menor custo e rapidez | Teste frases reais antes de escalar |
Resposta de WhatsApp | Flash/Turbo | Áudios curtos e recorrentes | Use cache para reaproveitar respostas |
Vídeo curto | Multilingual/v3 | Expressividade pode importar mais | Calcule o texto final antes de gerar |
Narração longa | Multilingual/v3 | Prioriza consistência e voz | Divida textos extensos e monitore custo |
Agente telefônico | Flash/Turbo | Resposta rápida é decisiva | Latência total depende do restante da pilha |
Para português brasileiro, não prometa sotaque perfeito sem teste. Há relatos de confusão entre português europeu e PT-BR em fluxos de voz. Use frases brasileiras, termos do negócio e números reais antes de liberar a automação. A escolha de voz pesa tanto quanto o modelo.
Workflow de produção: retry, cache, logs e limite de custo
A diferença entre uma demonstração e uma automação confiável aparece depois do primeiro sucesso. Em produção, adote esta checklist:
- Guarde a API key em credencial ou variável segura.
- Limpe o texto antes de enviar.
- Calcule um hash de
texto + voice_id + model_id. - Consulte o cache antes de chamar a ElevenLabs.
- Limite tentativas e defina espera entre elas.
- Salve o áudio e o identificador da execução.
- Registre caracteres, modelo, resultado e custo estimado.
- Defina um teto diário ou mensal de gerações.
- Teste PT-BR antes de ativar para clientes.
O n8n recomenda Retry On Fail e espera entre tentativas ao lidar com rate limits. Veja como o n8n trata Retry On Fail. Mas retry sem limite pode multiplicar chamadas pagas. Configure poucas tentativas, registre o erro e envie a execução falha para uma fila de revisão quando a recuperação automática não for segura.
Para log de custo, use uma fórmula simples: caracteres / 1000 × preço do modelo. Não é necessário prometer precisão cambial por execução. Registre o valor em dólar pela tabela vigente e, se exibir reais, marque a cotação usada. Esse cuidado é parecido com o que vale para qualquer custo de API em produção: o gasto pequeno só parece irrelevante até ganhar volume.
Casos de uso no Brasil
No atendimento por WhatsApp, use TTS quando a mensagem de voz melhora a experiência, não como enfeite em toda resposta. Confirmações, instruções de voz e retornos curtos podem ser bons casos. Para respostas repetitivas, cache reduz custo e mantém consistência.
Em vídeos curtos, o n8n pode receber um roteiro aprovado, gerar narração e enviar o arquivo para a etapa de edição.
Se a sua stack também precisa de imagem ou vídeo por API, uma plataforma como Kie.ai ou uma API multimodal como WaveSpeedAI pode complementar a voz. Avalie cada integração pelo controle de custos, não só pela quantidade de modelos.
Aulas, narrações e conteúdo acessível também se beneficiam do fluxo. Nesses casos, divida textos longos, guarde os MP3s e mantenha versão do roteiro. Para agentes telefônicos, a voz é apenas uma parte: telefonia, transcrição, regras de negócio e encaminhamento humano precisam de desenho próprio.
Problemas comuns e como resolver
Erro 401 ou 403
Confira se xi-api-key está vindo da credencial correta, se a chave está ativa e se você não digitou o nome do header errado. Revise o plano e as permissões antes de repetir a chamada em loop.
O áudio não aparece como arquivo
Revise a configuração de resposta do HTTP Request. O retorno deve ser manipulado como binário. Depois, confirme qual propriedade binária o node seguinte espera. Um teste com um único texto curto simplifica o diagnóstico.
A voz sai com sotaque inadequado
Teste a voz escolhida com frases brasileiras, abreviações e nomes que seu público realmente usa. Ajuste a voz antes de mudar modelo ou aumentar volume. Qualidade de PT-BR deve ser validada no seu caso, não presumida.
Os créditos acabam rápido
Examine os logs por tamanho médio de texto, chamadas duplicadas e retries. Compare o total de caracteres com a fórmula de Custo por Fala Gerada. Em muitos casos, encurtar a resposta e reutilizar o MP3 resolve mais do que trocar de plano.
FAQ
Como conectar ElevenLabs no n8n?
Use o node oficial, se estiver disponível no seu ambiente, ou um HTTP Request com POST para o endpoint de Text-to-Speech, header xi-api-key e corpo JSON com texto e modelo.
Preciso do node oficial da ElevenLabs?
Não. O node oficial simplifica operações suportadas. HTTP Request continua sendo uma rota útil para controle detalhado, compatibilidade e recursos que o node ainda não exponha.
Como salvar o MP3 gerado pela ElevenLabs no n8n?
Configure o retorno como binário e envie essa propriedade para um node de armazenamento, mensageria ou webhook que aceite arquivo. Use nomes de arquivo sem dados pessoais.
Quanto custa gerar áudio em uma automação?
O preço depende de caracteres e modelo. Pela tabela de API pesquisada, Flash/Turbo custa US$ 0,05 por mil caracteres e Multilingual/v3 custa US$ 0,10. A conversão para reais varia com o dólar.
ElevenLabs funciona bem em português brasileiro?
Os modelos multilíngues suportam vários idiomas, mas não existe benchmark público definitivo para todos os cenários de PT-BR. Teste voz e frases reais antes de automatizar para clientes.
O plano gratuito funciona com API e n8n?
Regras de API e limites de planos podem mudar. Confira as condições vigentes na conta e faça uma chamada curta antes de desenhar uma automação dependente desse acesso.
Vale usar ElevenLabs no n8n?
Vale quando a voz melhora uma etapa concreta do produto, do atendimento ou da produção de conteúdo. O node oficial reduz atrito. O HTTP Request mantém controle. Mas o ponto decisivo é o Custo por Fala Gerada: caracteres, modelo, repetição e retry definem a fatura real.
Comece com um fluxo curto, armazene o MP3, registre consumo e só depois escale. Para escolher a ferramenta e acessar a rota de contratação sem perder o contexto da integração, conheça a ElevenLabs para automações de voz IA no Runzos.