LangChain vs LlamaIndex vs n8n: stack para agentes de IA em 2026
Por Maicon Ramos · · 9 min de leitura
Navegue por tópicos
- Tabela comparativa: qual camada está faltando?
- Para quem é o n8n e onde ele ganha
- Para quem é o LlamaIndex e onde ele ganha
- Para quem é LangChain com LangGraph e onde ganha
- Infraestrutura: a demo não é a operação
- Quando não usar agente, RAG ou VPS
- Três stacks por cenário
- FAQ sobre LangChain, LlamaIndex e n8n
- Veredito: comece pelo gargalo que você consegue operar
Para o solo builder, n8n é a escolha inicial quando o gargalo são integrações, gatilhos e aprovações. LlamaIndex ganha quando o agente precisa consultar dados próprios com ingestão e recuperação organizadas. LangChain com LangGraph ganha quando o produto exige estado, decisões e retomadas no código. A ressalva é operacional: não instale as três camadas sem uma responsabilidade concreta para cada uma.
A pergunta não é qual ferramenta vence. LangChain, LlamaIndex e n8n têm sobreposições, mas atacam gargalos diferentes. A decisão útil é localizar onde a aplicação trava hoje: no processo entre serviços, no acesso a documentos ou no comportamento do agente.
A tese deste comparativo é a Arquitetura de Camadas, não Pilha de Logos. Cada peça deve assumir um trabalho específico: integração, dados, raciocínio ou operação. Isso evita uma stack feita para demo e difícil de atualizar, observar e restaurar.
Tabela comparativa: qual camada está faltando?
💡 Vai rodar n8n numa VPS? A gente comparou o preço real em cada provedor — com renovação e requisitos — em VPS para n8n.
Decisão | LangChain/LangGraph | LlamaIndex | n8n |
|---|---|---|---|
Problema dominante | Comportamento customizado do agente | Dados próprios e recuperação | Integrações e processos |
Interface principal | Código e grafo de execução | Código, conectores e workflows | Canvas visual, nós e webhooks |
Dados e RAG | Compõe com a aplicação | Foco em ingestão e consulta | Conecta nós e serviços |
Estado e orquestração | Controle fino com LangGraph | Workflows event-driven | Execuções e processos operacionais |
Perfil técnico | Dev disposto a testar código | Dev focado em dados | Operador de automação e integrações |
Licença consultada | MIT | MIT | Sustainable Use License |
Quando evitar | Fluxo linear e simples | Sem corpus ou pergunta baseada em dados | Produto que exige lógica complexa no código |
A tabela não mede desempenho. Não há benchmark reproduzido que permita um vencedor universal. Modelo, corpus, ferramentas, concorrência e métrica mudam o resultado.
Para quem é o n8n e onde ele ganha
n8n é a primeira escolha para o solo builder cujo trabalho começa em um evento: webhook, formulário, planilha, CRM, e-mail, aprovação ou chamada de API. A plataforma visual é adequada para deixar o processo visível e conectar serviços sem concentrar toda regra de negócio em um único serviço de código.
Ele ganha em três situações. Primeiro, quando integrações e gatilhos são o gargalo. Segundo, quando alguém precisa visualizar, revisar ou aprovar etapas. Terceiro, quando o fluxo ainda é linear o bastante para o canvas explicar o que acontece. Os nós de IA do n8n implementam o framework JavaScript do LangChain e se conectam aos nós normais da plataforma, segundo a documentação do n8n sobre LangChain.
Ele perde prioridade quando o produto precisa de estado próprio, testes de unidade, schemas e muitas decisões condicionais no código. Nesse caso, o n8n pode continuar como borda operacional, recebendo e disparando eventos. A decisão central vive em um serviço próprio.
Para quem é o LlamaIndex e onde ele ganha
LlamaIndex é para o dev cuja pergunta depende de documentos, bases privadas, metadados e recuperação. RAG só faz sentido quando existe corpus, regra de acesso e necessidade de responder a partir desse material. Histórico de chat não é memória de longo prazo: contexto precisa de armazenamento, recuperação, atualização e descarte.
Ele ganha quando a ingestão e a consulta são o centro do produto. A documentação do LlamaIndex o apresenta como framework para agentes, dados e workflows com LLMs. Seus workflows event-driven combinam handlers que recebem eventos e emitem novos eventos. Isso cobre agentes, RAG e extração, mas não elimina avaliação de relevância nem permissões.
Para uma aplicação PostgreSQL-first, o pgvector permite busca por similaridade no PostgreSQL, com busca exata ou aproximada e índices HNSW ou IVFFlat. Qdrant é uma alternativa dedicada com APIs REST e gRPC, filtros de payload e snapshots. Nenhuma escolha gera uma regra universal de RAM: vetores, payload, índices, réplicas, corpus e carga definem a operação.
LlamaIndex não é a primeira camada para um fluxo sem corpus próprio. Também não substitui, sozinho, uma plataforma de processos SaaS. Ele ganha na camada de dados, não por ser um rótulo genérico de agente.
Para quem é LangChain com LangGraph e onde ganha
LangChain com LangGraph é para o dev que precisa controlar o comportamento do agente em código. LangChain descreve create_agent como um harness configurável com modelo, ferramentas, prompt e middleware. LangGraph entra quando decisões, estado e interrupções precisam de um caminho explícito.
Ele ganha quando o produto deve registrar onde parou, combinar passos determinísticos e etapas guiadas por LLM, ou retomar uma execução sob regras da aplicação. A documentação do LangGraph descreve essa mistura de passos escritos à mão e passos orientados por LLM no mesmo grafo.
Essa vantagem cobra código, testes, permissões, logs e tratamento de falhas. LangGraph não torna a resposta do LLM correta por definição. Para um fluxo linear, manter grafo, estado e serviço separado pode custar mais que usar webhook e API.
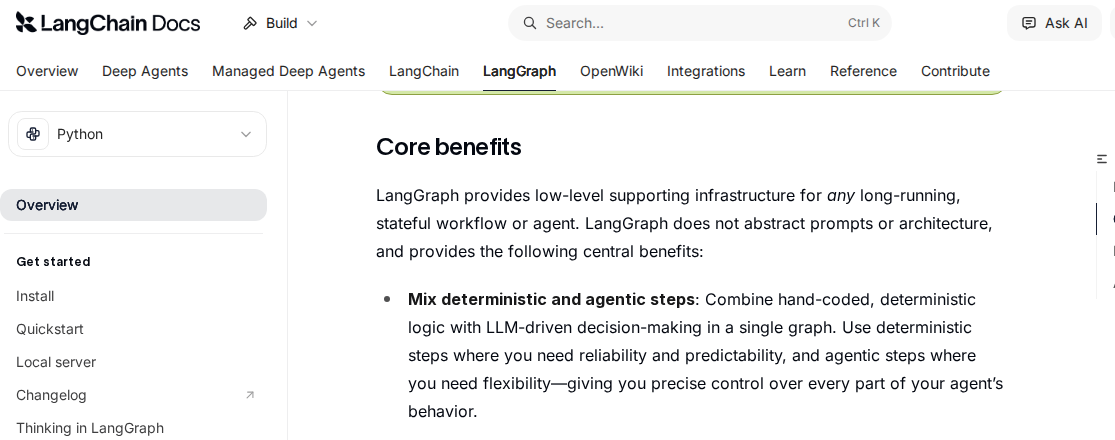
Trecho da seção “Core benefits” da documentação oficial do LangGraph, com a combinação de passos determinísticos e guiados por LLM. Captura em 30 de agosto de 2026.
Infraestrutura: a demo não é a operação
O AI Starter Kit do n8n reúne n8n self-hosted, Ollama, Qdrant e PostgreSQL para demonstração ou prova de conceito. Ele ajuda a enxergar as peças, mas não é uma arquitetura pronta de produção. O consumo depende de modelo local, embeddings, corpus, banco, concorrência, logs e retenção de execuções.
Comece pela persistência. A documentação Docker do n8n pede que o diretório .n8n seja persistido. Mesmo com PostgreSQL, ele mantém itens como chave de criptografia, logs e ativos de source control. Um dump do banco sozinho não recompõe todo o ambiente.
Quando a execução cresce, Queue Mode usa workers e Redis para transportar trabalho e respostas. A documentação do Queue Mode do n8n descreve Redis como parte dessa arquitetura. A própria documentação alerta que Simple Memory não serve para workflow ativo em produção nesse modo, pois chamadas podem cair em workers diferentes.
Checklist antes de chamar de agente em produção | O que confirmar |
|---|---|
Modelo e API | Credenciais, limites e falhas previsíveis. |
Permissões | Ferramentas e dados acessíveis somente ao necessário. |
Estado | Onde execução, conversa e aprovações são persistidas. |
RAG | Corpus, atualização, permissões e avaliação de relevância. |
Volumes e banco | Dados persistentes fora do container descartável. |
Chave de criptografia | Armazenada e recuperável junto da instalação. |
HTTPS e webhooks | Entrada protegida e URLs documentadas. |
Logs e limites | Rastreamento de falhas, duração e repetição. |
Backup e restauração | Banco, volumes, variáveis e credenciais recuperáveis em ambiente limpo. |
Uma VPS única não oferece alta disponibilidade, isolamento de dados ou recuperação automática por definição. Latência, residência de dados e disponibilidade dependem da região da VPS e dos provedores de LLM e embeddings escolhidos.
Para hospedar n8n, workers e automações, veja a VPS para n8n e automações. Se suporte em português, PIX ou boleto fizerem parte da decisão, há uma VPS brasileira com n8n e Coolify. Dimensione a aplicação antes de escolher o plano.
Quando não usar agente, RAG ou VPS
Evite LangGraph, banco vetorial, Redis e múltiplos containers quando um processo linear cabe em webhook e chamada de API. Evite RAG sem documentos próprios, requisito de citação ou pergunta dependente de dados privados. Evite self-hosting quando ninguém aceita guardar segredos, atualizar serviços, acompanhar logs, fazer backup e testar restauração.
Três stacks por cenário
Cenário | Primeira stack | Por quê | Próximo passo |
|---|---|---|---|
Solo builder automatizando processo | n8n e APIs | Webhooks, integrações e aprovações são o gargalo. | Adicionar código se a lógica crescer. |
Assistente sobre dados privados | LlamaIndex com pgvector ou Qdrant | Ingestão, recuperação e regras de acesso precisam ser tratadas. | Avaliar relevância e atualizar o corpus. |
Produto com decisão e estado próprio | LangChain com LangGraph | Caminho do agente, interrupções e retomada pedem controle explícito. | Conectar n8n apenas aos processos que merecem canvas. |
A combinação completa é válida quando cada peça responde a um requisito. n8n pode receber o evento e registrar a aprovação. LangGraph pode decidir a próxima etapa. LlamaIndex pode preparar a recuperação sobre dados próprios. pgvector ou Qdrant podem guardar a camada vetorial. Juntar tudo em uma aplicação simples cria custo operacional, não vantagem automática.
FAQ sobre LangChain, LlamaIndex e n8n
n8n substitui LangChain?
Não de forma geral. Os nós de IA do n8n implementam LangChain em JavaScript e atendem muitos fluxos visuais com integrações. Um produto que precisa controlar estado, schemas, interrupções e regras de decisão no código pode precisar de LangChain com LangGraph.
LlamaIndex é melhor que LangChain para RAG?
Não há base para declarar vencedor universal. LlamaIndex é uma escolha natural quando ingestão, fontes de dados e recuperação dominam o problema. Compare o mesmo corpus, modelo, permissões, métricas de relevância e carga antes de escolher por desempenho.
Posso usar n8n, LlamaIndex e LangGraph juntos?
Sim. Eles podem formar camadas complementares: n8n coordena eventos, LlamaIndex organiza dados e LangGraph controla um agente stateful. A combinação pede contratos, credenciais, persistência e tratamento de erros entre as camadas.
Preciso de Qdrant para um agente de IA?
Não necessariamente. Sem corpus privado ou requisito de recuperação, um agente pode não precisar de banco vetorial. Quando a aplicação já usa PostgreSQL, pgvector é uma opção a avaliar. Qdrant é um serviço vetorial dedicado; a decisão depende de dados, índices, carga e operação.
Quanta RAM preciso para rodar um agente em VPS?
Não existe mínimo universal confirmado. Modelo local, embeddings, corpus, banco vetorial, concorrência, logs e retenção de execuções mudam o consumo. Prototipe o fluxo, observe métricas e escolha recursos com margem para backup e monitoramento.
Quando Queue Mode do n8n faz sentido?
Quando a execução precisa de workers. A arquitetura usa Redis para transportar trabalho e respostas. Ela aumenta a capacidade operacional, mas adiciona Redis, workers, banco e pontos de backup e observabilidade. Para memória, use armazenamento compartilhado.
Veredito: comece pelo gargalo que você consegue operar
Para o solo builder, comece por n8n se o problema é processo entre serviços. Essa é a recomendação principal porque integrações, gatilhos e aprovações costumam aparecer antes de um corpus privado ou de um agente com estado próprio. Só avance para LlamaIndex quando dados próprios exigirem ingestão e recuperação. Só avance para LangGraph quando o produto exigir comportamento, estado e retomada controlados em código.
A Arquitetura de Camadas não é uma licença para empilhar logos. Antes de subir containers, registre onde ficam os dados, quem acessa as credenciais, como uma execução retorna e como o ambiente é restaurado. Para organizar infraestrutura própria, conheça a hospedagem para infraestrutura própria.