Extrair dados de PDF com n8n
Do PDF que chega por e-mail à planilha preenchida — sem digitação, usando o n8n e um modelo que lê o documento por você.
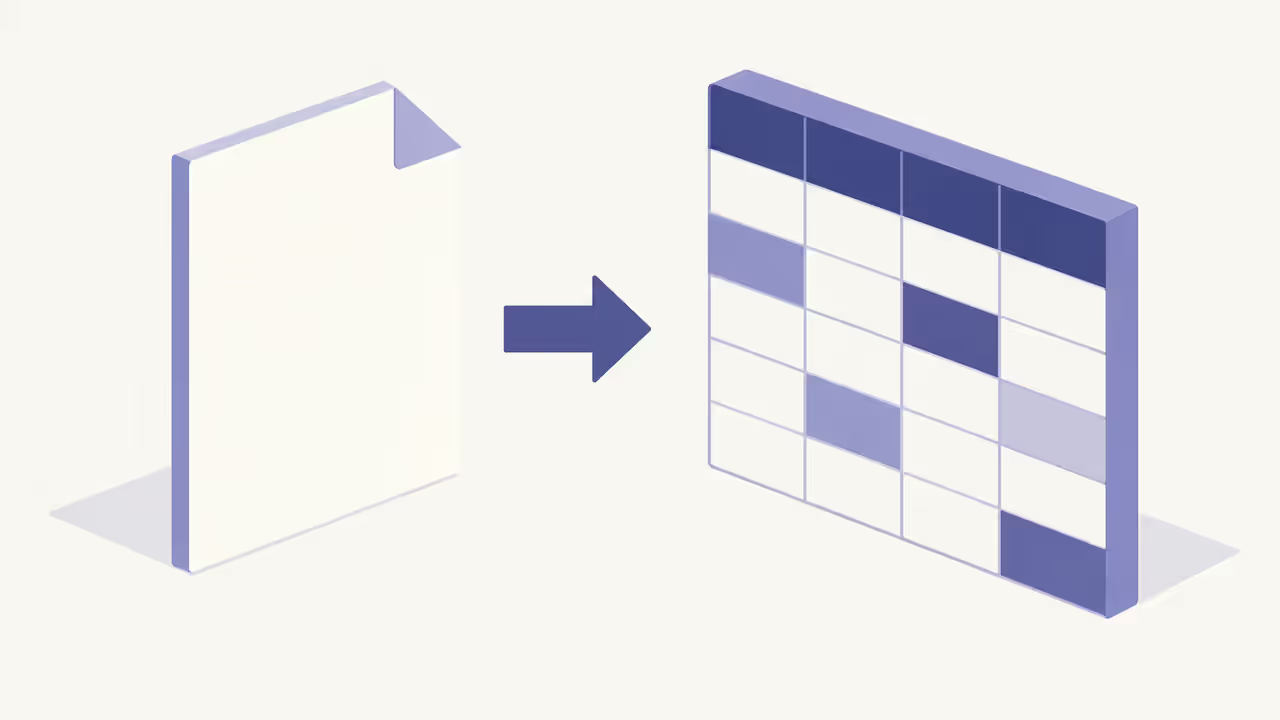
Extrair dado de PDF é o trabalho manual mais fácil de justificar automatizar: alguém está digitando à mão o que já está escrito. Nota fiscal, boleto, currículo, contrato, relatório — o dado existe, só não está em formato de planilha nem de banco.
Existem dois caminhos, e escolher errado custa tempo. Se o PDF tem texto de verdade, o nó nativo do n8n extrai sem custo de IA nenhum — é o template mais usado do recorte, com 96 mil usos, e resolve muita coisa. Se o PDF é digitalizado ou tem layout complexo, aí entra modelo de visão, que lê a página como imagem e devolve campo estruturado. Comece sempre pelo primeiro: é grátis e responde na hora se serve para o seu caso.
Como montar
- Suba o n8n numa VPS (ofertas abaixo, instalação em um clique).
- Importe primeiro o template de extração simples e teste com um PDF seu.
- Se voltar texto, seu problema acabou — mande a saída para planilha ou banco.
- Se voltar vazio, o PDF é digitalizado: troque para o template com modelo de visão.
- Defina os campos que você quer de saída antes de ligar o volume — extração sem esquema definido devolve texto solto e você recai na digitação.
O que você precisa
VPS 2 GB + n8n; IA só é necessária para PDF digitalizado ou layout complexo
- 1. VPS com n8n — 2 GB bastam; PDF grande consome mais memória momentaneamente, então evite processar lote enorme em paralelo.
- 2. Modelo de visão (só às vezes) — necessário apenas se o PDF for digitalizado. Para PDF com texto, o nó nativo resolve sem custo de IA.
- 3. Destino do dado — planilha, banco ou API. Decida isso antes: é o que define quais campos você precisa extrair.
Quanto custa
Aqui o custo varia muito conforme o tipo de PDF. Documento com texto sai de graça — é processamento local, sem IA. Documento digitalizado passa por modelo de visão, e aí você paga por página analisada.
R$ 30 a R$ 70/mês (VPS); PDF com texto não consome IA · VPS de 2 GB
Onde hospedar
 HostingerHostinger VPS n8n +70% de Desconto (Workflows ilimitados)Hospedagem recomendada pelo WordPress.org, com instalação 1 clique, staging (ambiente de testes), atualizações automáticas inteligentes, SSL ilimitado, WP-CLI/SSH/Git, CDN própria, detector de…70% OFF
 ServlaServla VPS n8n — VPS Brasileira com Coolify e n8n Pré-instaladosA Servla é uma empresa brasileira de infraestrutura em nuvem com data center próprio no Brasil (Cirion, Cotia/SP). O plano VPS n8n vem com Coolify pré-instalado, permitindo instalar o n8n em poucos…a partir de R$ 69,90
Veredito
Teste o extrator simples antes de qualquer coisa: se o seu PDF tem texto, o problema está resolvido de graça. Modelo de visão só entra quando o extrator volta vazio — e aí a conta passa a ser por página.